第三章:轉錄設定與模型選擇
單一轉譯頁面的每個選項、各種語言該選哪個模型、進階設定(辨識說話人、熱詞、提示詞),以及讓字幕更準的小技巧。
第三章:轉錄設定與模型選擇
「轉錄」就是把聲音打成文字。這一章說明 「單一轉譯」 頁面上每個選項的意思,以及怎麼挑模型。
3.1 上方的六個分頁
| 分頁 | 什麼時候用 |
|---|---|
| 本地文件 | 轉錄電腦裡的錄音或影片(最常用,本章 3.2~3.6) |
| 錄音 | 在 Scribis 裡用麥克風錄一段,再轉成文字 |
| 批量分割與轉錄 | 把一個很長的檔案自動切成好幾段,每段各自轉錄 |
| URL轉譯 | 貼上網路影片網址(例如 YouTube),下載後轉錄 |
| OCR | 把「印在影片畫面上的字幕」讀出來,變成可以編輯的字幕 |
| 影像錄製 | 一邊播影片、一邊錄自己的旁白,做配音或口述字幕 |
右上角的 「使用教學」 可以隨時打開這一頁的操作說明。後五個分頁的詳細用法在本章最後的 3.7。
3.2 語言設定
- 自動檢測:讓 Scribis 自己判斷講什麼語言。適合不確定或混雜多種語言的影片。
- 指定語言:從下拉選單選一種語言。知道語言時一定要選,辨識會更準,也比較不會出現奇怪的字。
- 僅分離音訊(不轉寫):只把影片的聲音抽出來,不轉成文字。
3.3 選擇模型
在 「模型設定」 打勾 「使用本地語音辨識模型」,下方的下拉選單會列出你能用的模型:
⚠️ 下拉選單只會顯示「已下載、而且按過星號(加入最愛)」的模型。 下載後如果找不到,到「設置 → 最愛」或「設置 → 模型 → 語音轉錄」,在那個模型按星號。
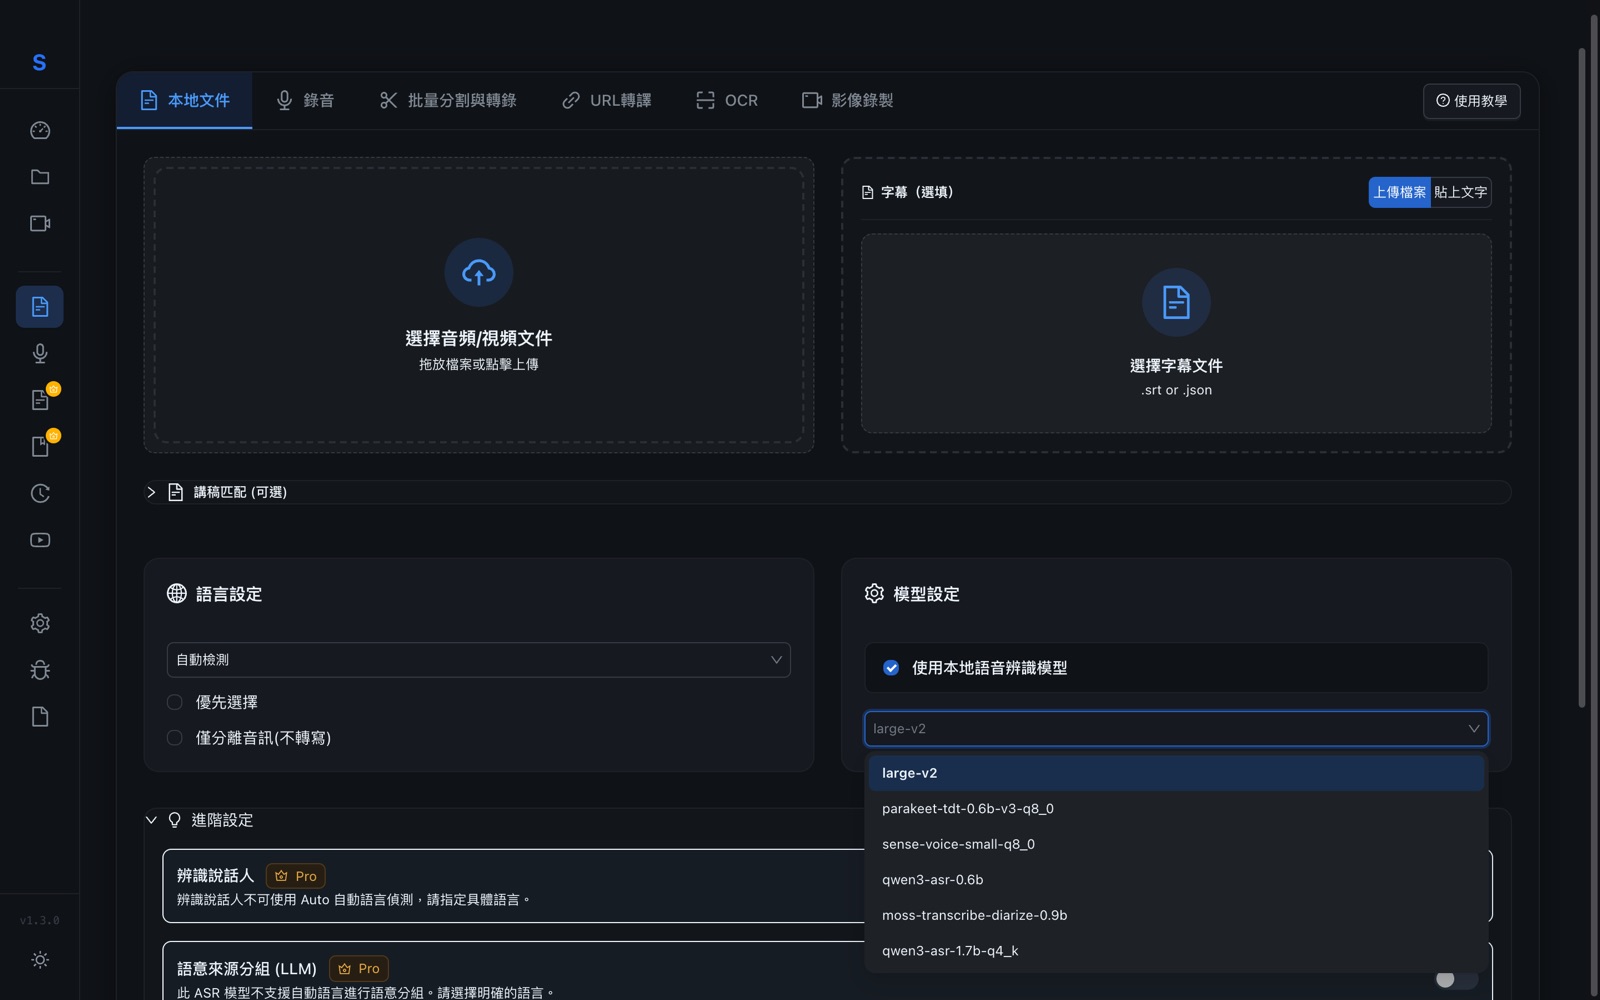
清單裡沒有想要的模型?到 「設置 → 模型 → 語音轉錄」 下載(見第二章)。
該選哪一個?
模型名字看不懂沒關係,照「你的情況」那一欄選就好。 最簡單的做法:用第一次開啟時推薦的模型。
| 你的情況 | 選名稱裡有這個字的模型 | 在設置裡的分類 | 特色 |
|---|---|---|---|
| 不知道選什麼 | qwen3-asr-0.6b | 推薦首選 | 多種語言都不錯,速度和準確度平衡 |
| 台灣中文、中英夾雜 | breeze-asr(免費版可用 breeze-asr-25-q8_0,其餘為 Pro) | 繁體中文 | 特別熟悉台灣口音與繁體中文 |
| 中文、粵語、日文、韓文,電腦比較舊 | sense-voice | 中日韓與粵語(畫面上寫 CJK / 粵語) | 非常快,一般筆電也很順 |
| 英文或歐洲語言 | parakeet | 英文 + 歐洲文 | 英文又準又快,不需要顯示卡 |
| 英文,想要更快 | distil-large-v3(Pro) | 英文快速 | 速度優先 |
| 其他語言 | Whisper(tiny、base 免費;small 以上為 Pro) | 通用型(Whisper,支援 99 種以上語言) | 支援 99 種以上語言;越大越準,但越慢、越占空間 |
| 長篇內容、要最高品質 | vibevoice(Pro)或 qwen3-asr-1.7b(Pro) | 進階模型 | 需要較新、較好的電腦(例如較新的 Apple 晶片 Mac;不確定就先用上面幾個) |
💡 進階:改用雲端服務(可略過)。取消勾選「使用本地語音辨識模型」,可以改用網路上的服務(例如 Google Gemini、OpenAI)來轉錄。做法:先到該服務的網站申請一組 API 金鑰(一串像密碼的文字,不要分享給別人;部分服務需要付費),再到 「設置 → API 金鑰」 貼上。使用時聲音會傳到該公司處理。
3.4 進階設定
點 「進階設定」 展開更多選項。這些都是選用的,不設定也能正常轉錄:
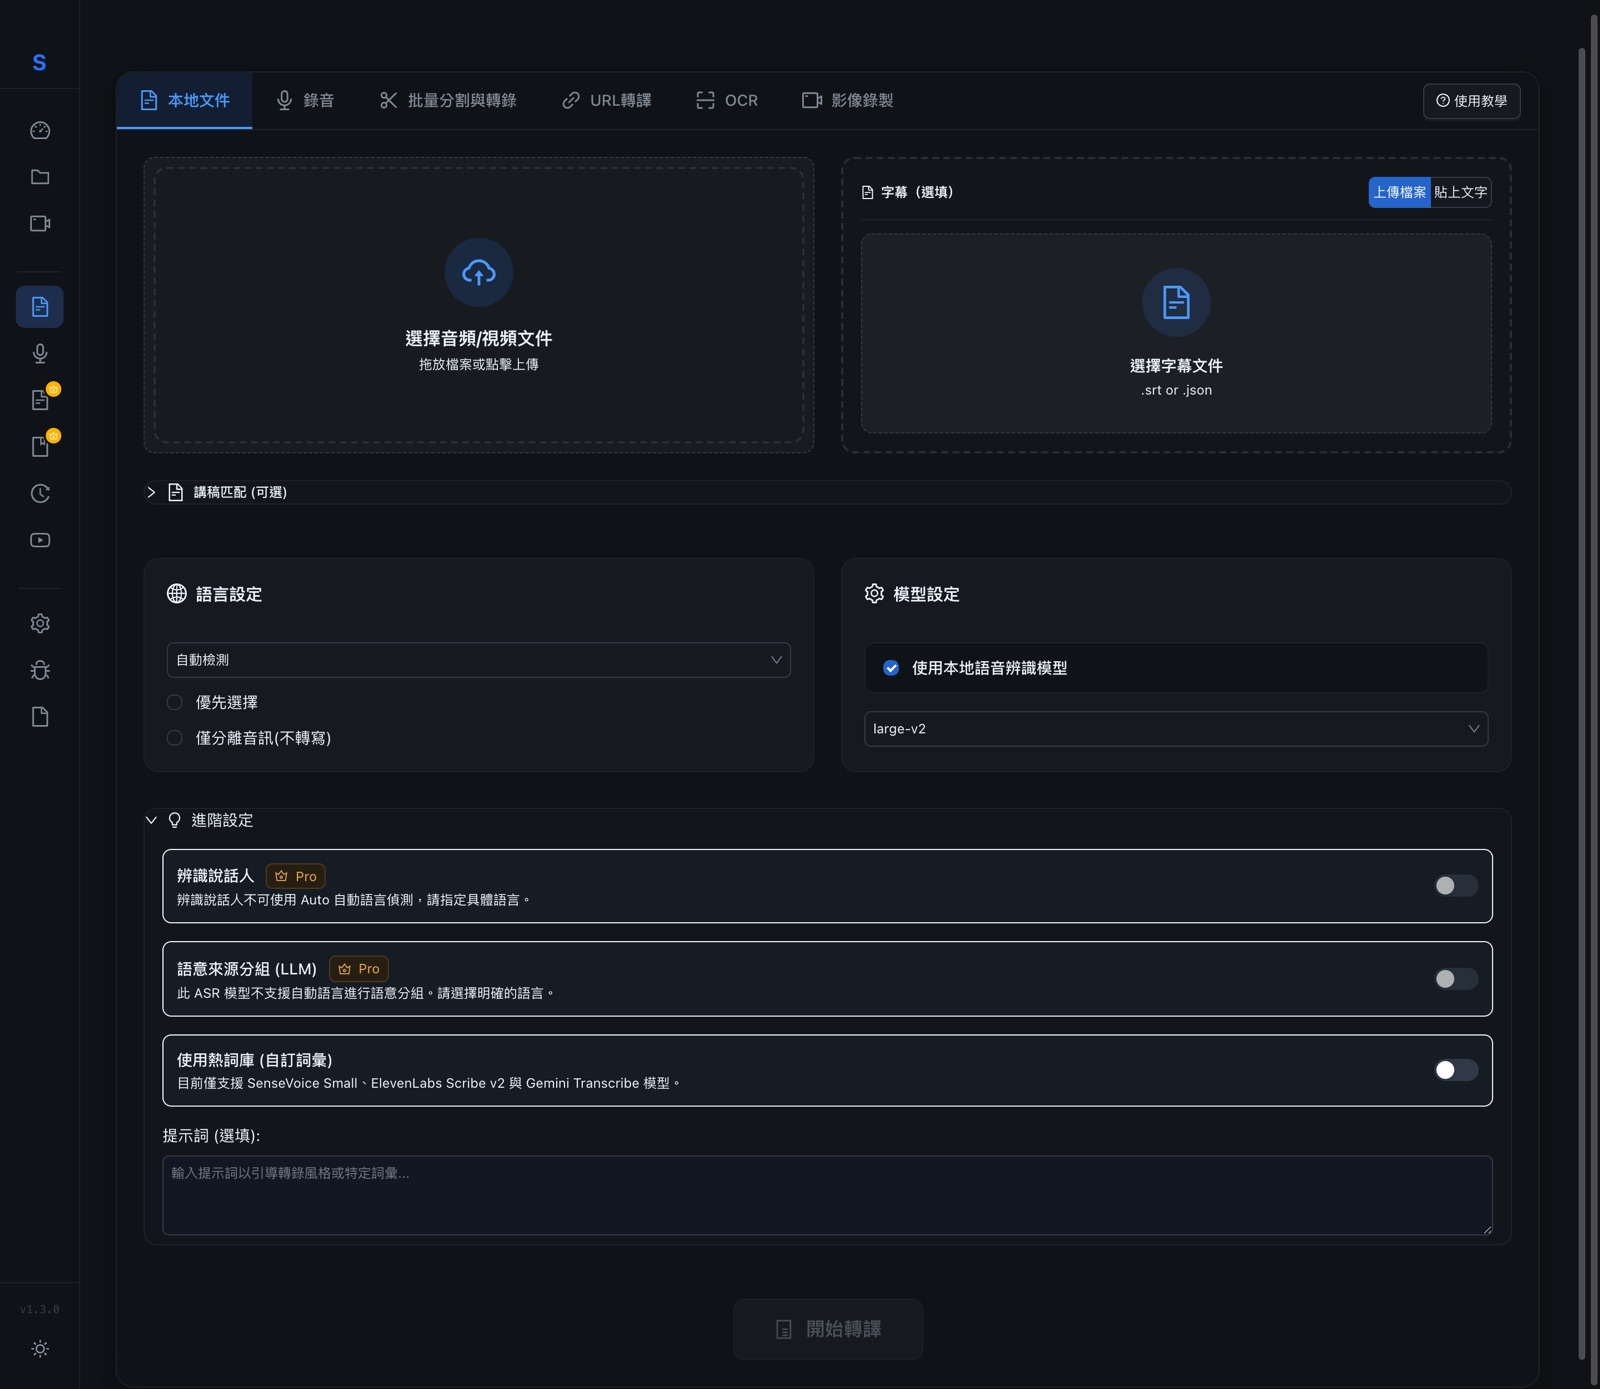
- 辨識說話人(Pro):多人對話時,自動分出「說話人 1、說話人 2」。使用前要先指定語言,不能用自動檢測。搭配聲紋還能直接標上名字。
- 語意來源分組 (LLM)(Pro):開啟後,AI 會依照句子的意思決定字幕在哪裡分段,讓每一段字幕更完整(LLM 就是能讀懂文字的 AI)。同樣需要指定語言。
- 使用熱詞庫(自訂詞彙):「熱詞」就是你事先登記的人名、公司名、專有名詞,打開後模型會特別注意這些詞。熱詞要先加到 「自訂辭典與聲紋 → ASR 辭典」(見第九章)。目前只有 SenseVoice Small、ElevenLabs Scribe v2、Gemini Transcribe 支援;用其他模型時,請改用下面的「提示詞」寫出專有名詞。
- 提示詞(選填):就是給模型的「背景說明」。用一兩句話告訴它這段內容在講什麼,它比較能認出人名和專有名詞,例如:
- 「這是一場關於 Scribis、Gemini 與 Kubernetes 的產品會議。」
- 「請使用繁體中文與台灣用語。」
3.5 已經有字幕或講稿?
- 字幕(選填):已經有
.srt或.json字幕檔時,可以一起上傳,直接帶著字幕進編輯器,或用來當作參考。也可以切到 「貼上文字」 直接貼上。 - 講稿匹配(可選):如果你有事先寫好的講稿,展開這一區貼上講稿,Scribis 會盡量用講稿上的正確文字來對齊聲音。
3.6 讓字幕更準的 5 個小技巧
- 指定語言,不要每次都用自動檢測。
- 錄音環境安靜一點,麥克風靠近說話的人。
- 專有名詞多的內容,在提示詞寫出人名、品牌和術語,或加進 ASR 辭典的熱詞。
- 換一個模型試試:同一段錄音,不同模型的表現可能差很多。
- 轉完再用 AI 修錯字:第七章的「優化」會找出可能聽錯的字讓你確認。
⏱️ 免費版限制:單一檔案最長 30 分鐘。Pro 版沒有長度限制。
3.7 其他五個分頁怎麼用
錄音:在 Scribis 裡直接錄
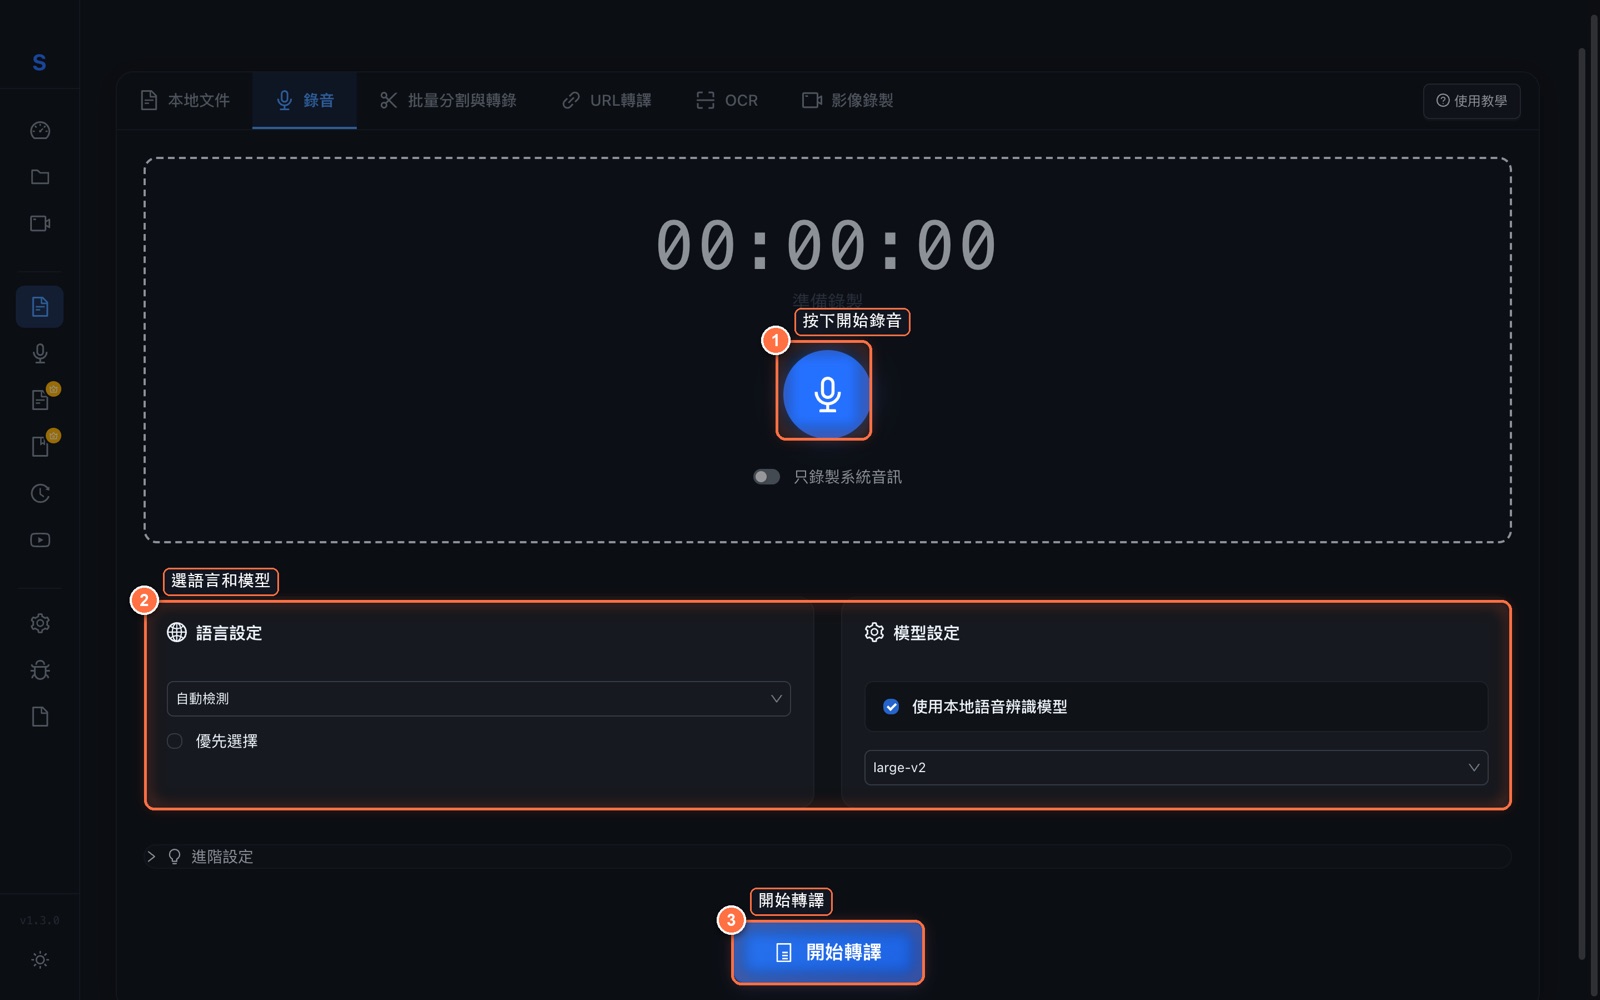
- 按中間的 藍色麥克風 開始錄音。錄音中會出現 暫停(灰色)和 停止(紅色方塊)兩個按鈕。
- 按停止後,畫面會顯示「Recording saved」和檔名,代表錄音已存好。旁邊的垃圾桶可以丟掉這段重錄。
- 選好語言和模型,按 「開始轉譯」。錄音本身不會自動轉文字,一定要按這個按鈕。
- 完成後會打開字幕編輯器。
- 只錄製系統音訊:錄電腦正在播放的聲音(例如線上會議裡別人的聲音、網路影片)。注意:在「設置 → 音訊擷取」裡「包含麥克風」預設是開著的,所以你自己的聲音也會一起錄進去;只想錄別人時,到那裡把它關掉。Mac 需要「螢幕與系統錄音」權限:蘋果選單 →「系統設定」→「隱私權與安全性」→「螢幕與系統錄音」,打開 Scribis(可能需要重新開啟 Scribis)。
- 免費版每次最多錄 10 分鐘,時間到會自動停止。
- 重新開始錄音會清掉上一段,記得先轉錄。
💡 想一邊錄一邊看到字幕?用左側選單的 「錄製」 頁面或迷你錄音機(第五章)。
批量分割與轉錄:把很長的檔案切段
適合 2~3 小時的課程或會議錄音(免費版也能用這個分頁;左側選單的「批量轉譯」頁面才是 Pro):Scribis 會在「沒有人說話的空檔」把檔案切開,每一段都變成媒體庫裡獨立的一個檔案,方便分開編輯。
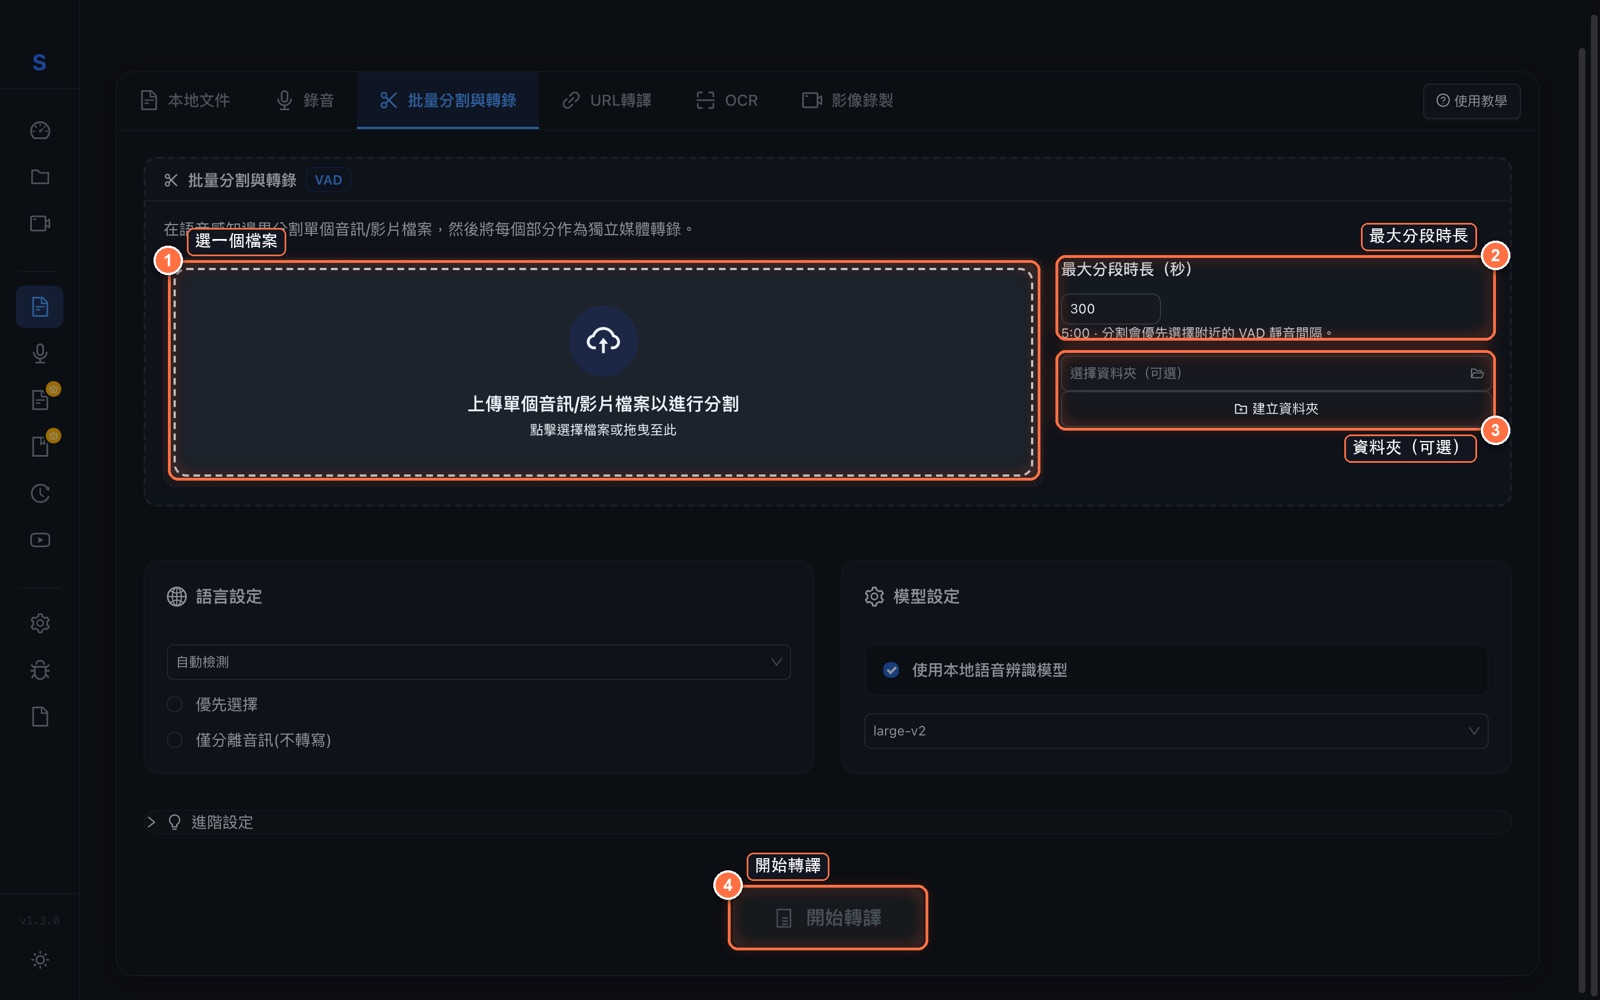
- 在 「上傳單個音訊/影片檔案以進行分割」 選一個檔案。
- 最大分段時長(秒):每一段最長可以多久。欄位單位是「秒」,預設 300(5 分鐘),可以填 10 到 3600(60 分鐘)。
- (可選)選擇資料夾,或按 「建立資料夾」 新建一個,所有分段都會放進去。
- 選好語言和模型,按 「開始轉譯」。
- 完成後列出 「已建立的媒體」。只有第一段會自動打開字幕編輯器,其他段請到媒體庫開啟。
- 這個分頁不會辨識說話人(就算打開也會被忽略)。
- 中途有一段失敗,整個流程會停止,但已完成的段落會留在媒體庫。
URL轉譯:貼上網址直接轉
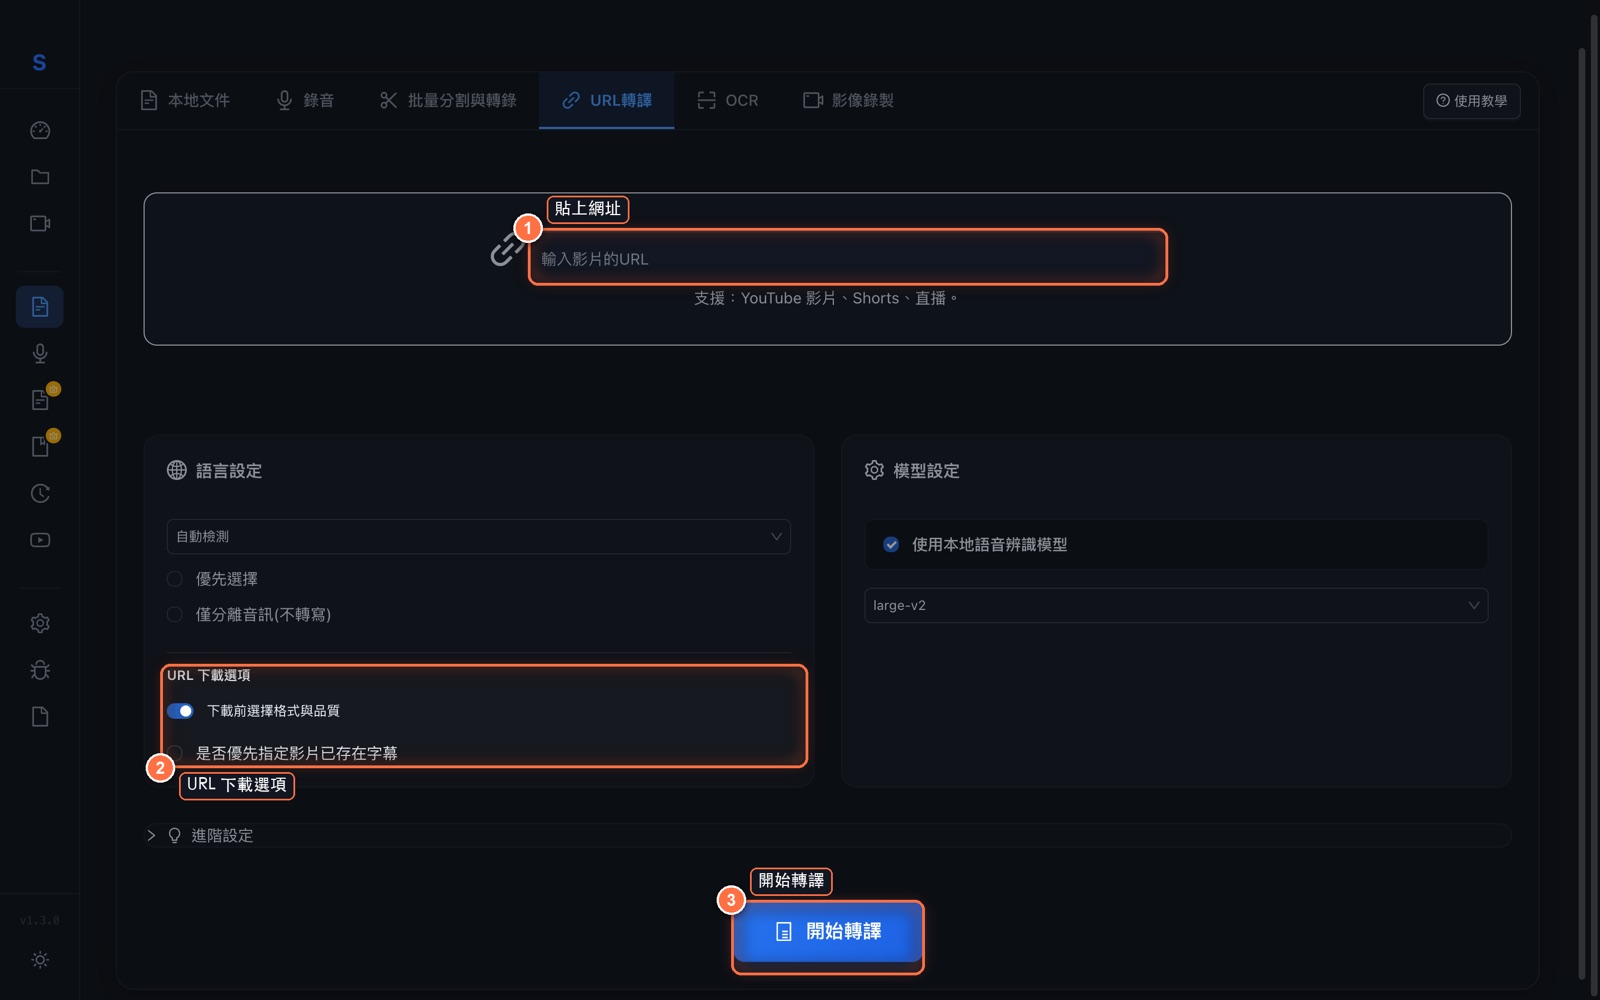
- 在 「輸入影片的URL」 貼上 YouTube 影片、Shorts 或直播的網址。
- 下方 「URL 下載選項」:
- 下載前選擇格式與品質:開啟後,按開始會先跳出視窗讓你選畫質和音軌,再按 「確認並開始轉錄」。
- 是否優先指定影片已存在字幕:影片本身有字幕時,直接拿來用,不用重新辨識。(大量使用可能會被 YouTube 限制。)
- 選好語言和模型,按 「開始轉譯」,完成後會打開字幕編輯器。
⚠️ 看不到這個分頁? 「網路影片」功能預設是關閉的。到 「設置 → 網路影片」,按 「取得 yt-dlp」(下載器)並打開開關即可。Mac App Store 版沒有這個功能。請只下載你有權使用的影片。
OCR:讀出畫面上的字幕
OCR 是「把畫面上的文字讀成文字」的技術。如果影片的字幕是印在畫面上的(沒有字幕檔),OCR 可以把它讀出來,變成可以編輯的字幕。
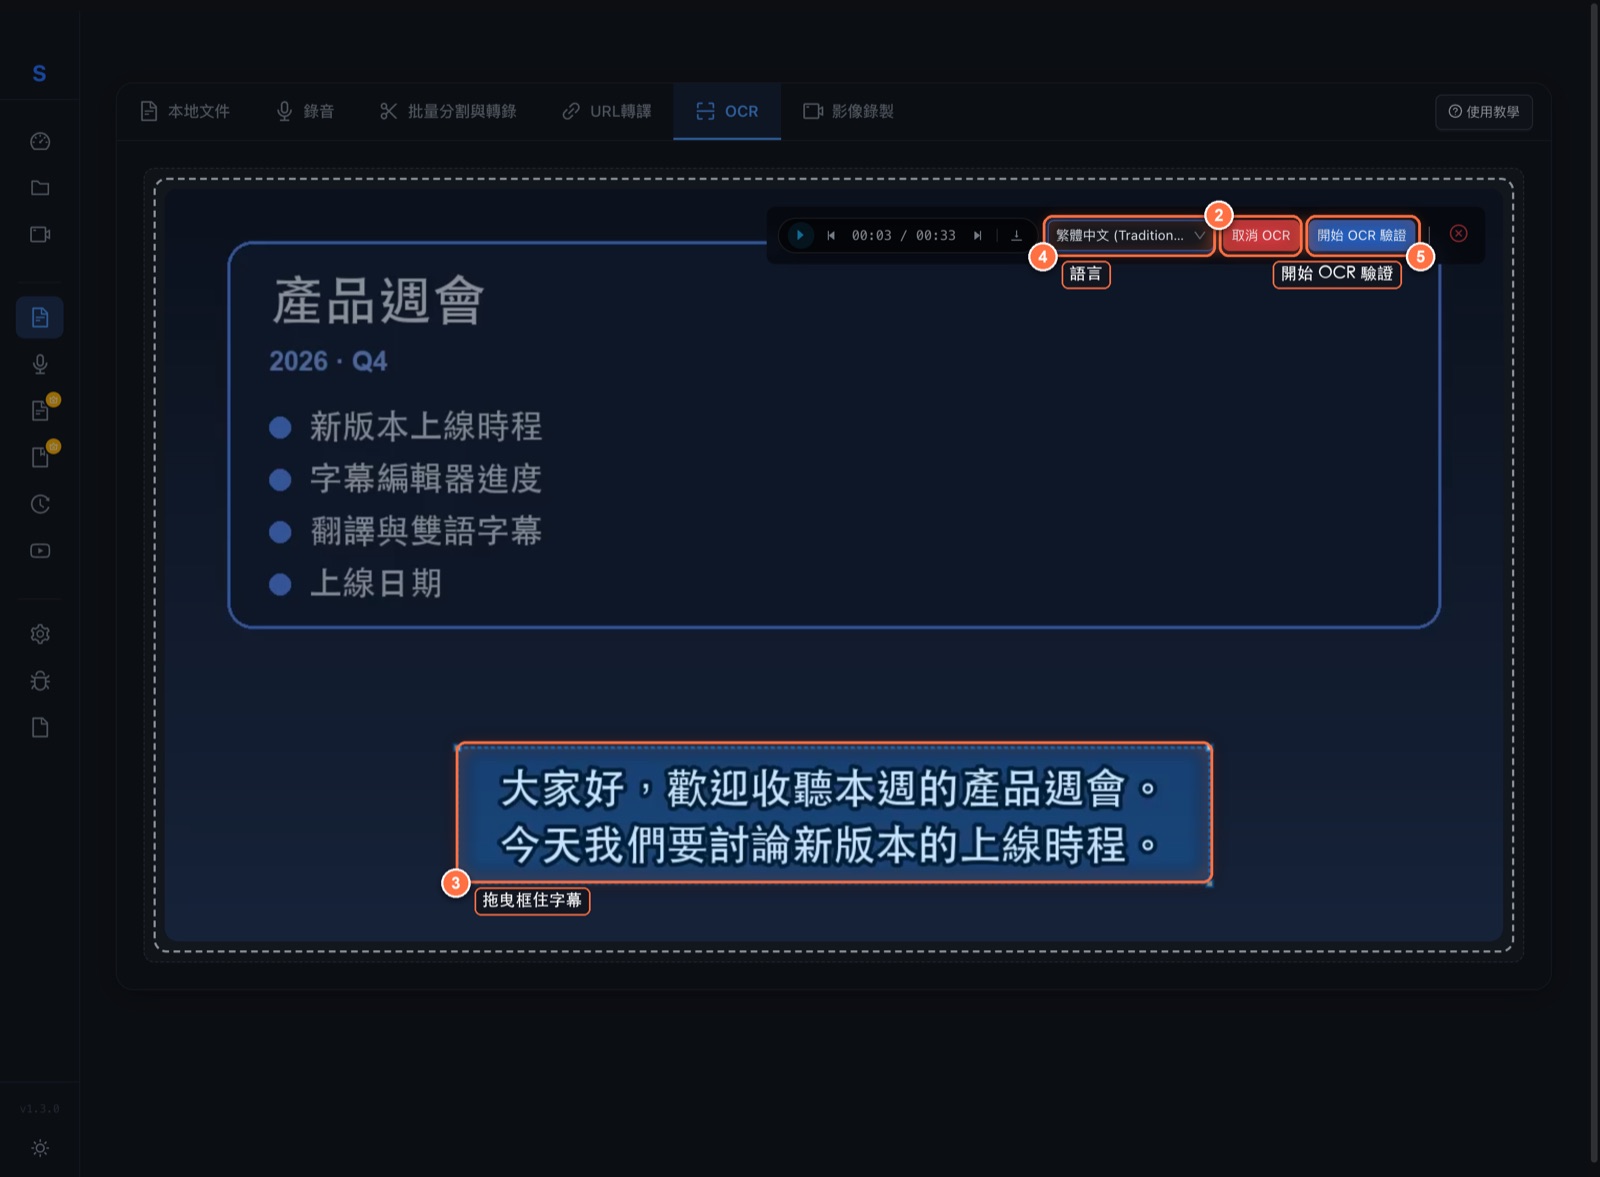
- 選一個影片檔(
.mp4、.mov、.mkv等)。 - 按右上角的 「OCR 框選」。
- 用滑鼠在影片上 拖曳出一個框,框住字幕出現的位置(通常是畫面下方)。
- 選擇字幕的語言(Windows 還可以選辨識引擎)。
- 按 「開始 OCR 驗證」,開始辨識畫面上的字。完成後會打開字幕編輯器,顯示讀出來的字幕:
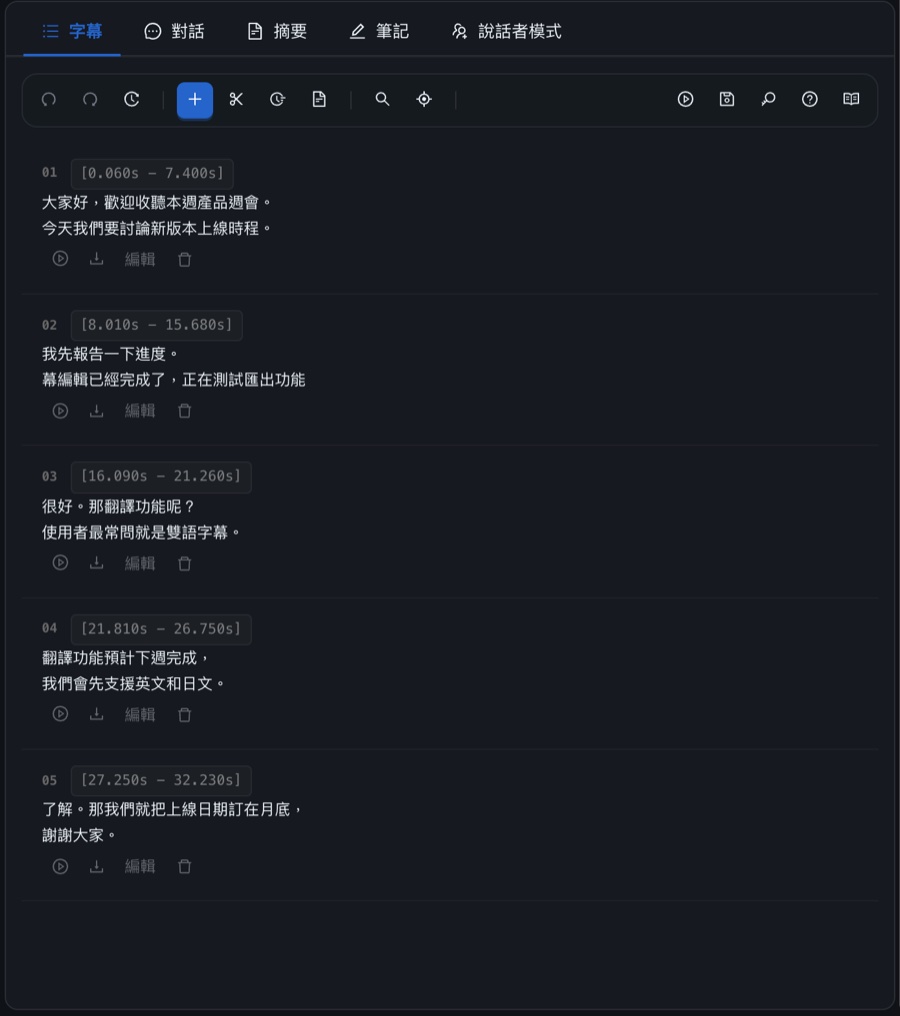
💡 OCR 偶爾會讀錯或漏掉一兩個字(例如上圖第 2 句把「字幕編輯器」讀成「幕編輯器」),完成後請快速看過一遍再匯出。
- Mac 使用系統內建的辨識,不用下載;Windows 第一次使用時會提示下載辨識模型(約 21 MB)。
- OCR 只會讀「有人說話的時段」(Scribis 先用聲音找出說話的位置,再去讀那幾段的畫面)。如果影片只有音樂或沒有人聲,會顯示「找不到語音片段」。
- 免費版最多處理 30 分鐘的影片。
影像錄製:一邊看影片一邊錄旁白
適合幫影片配旁白、口述解說,或用講的方式快速做字幕。
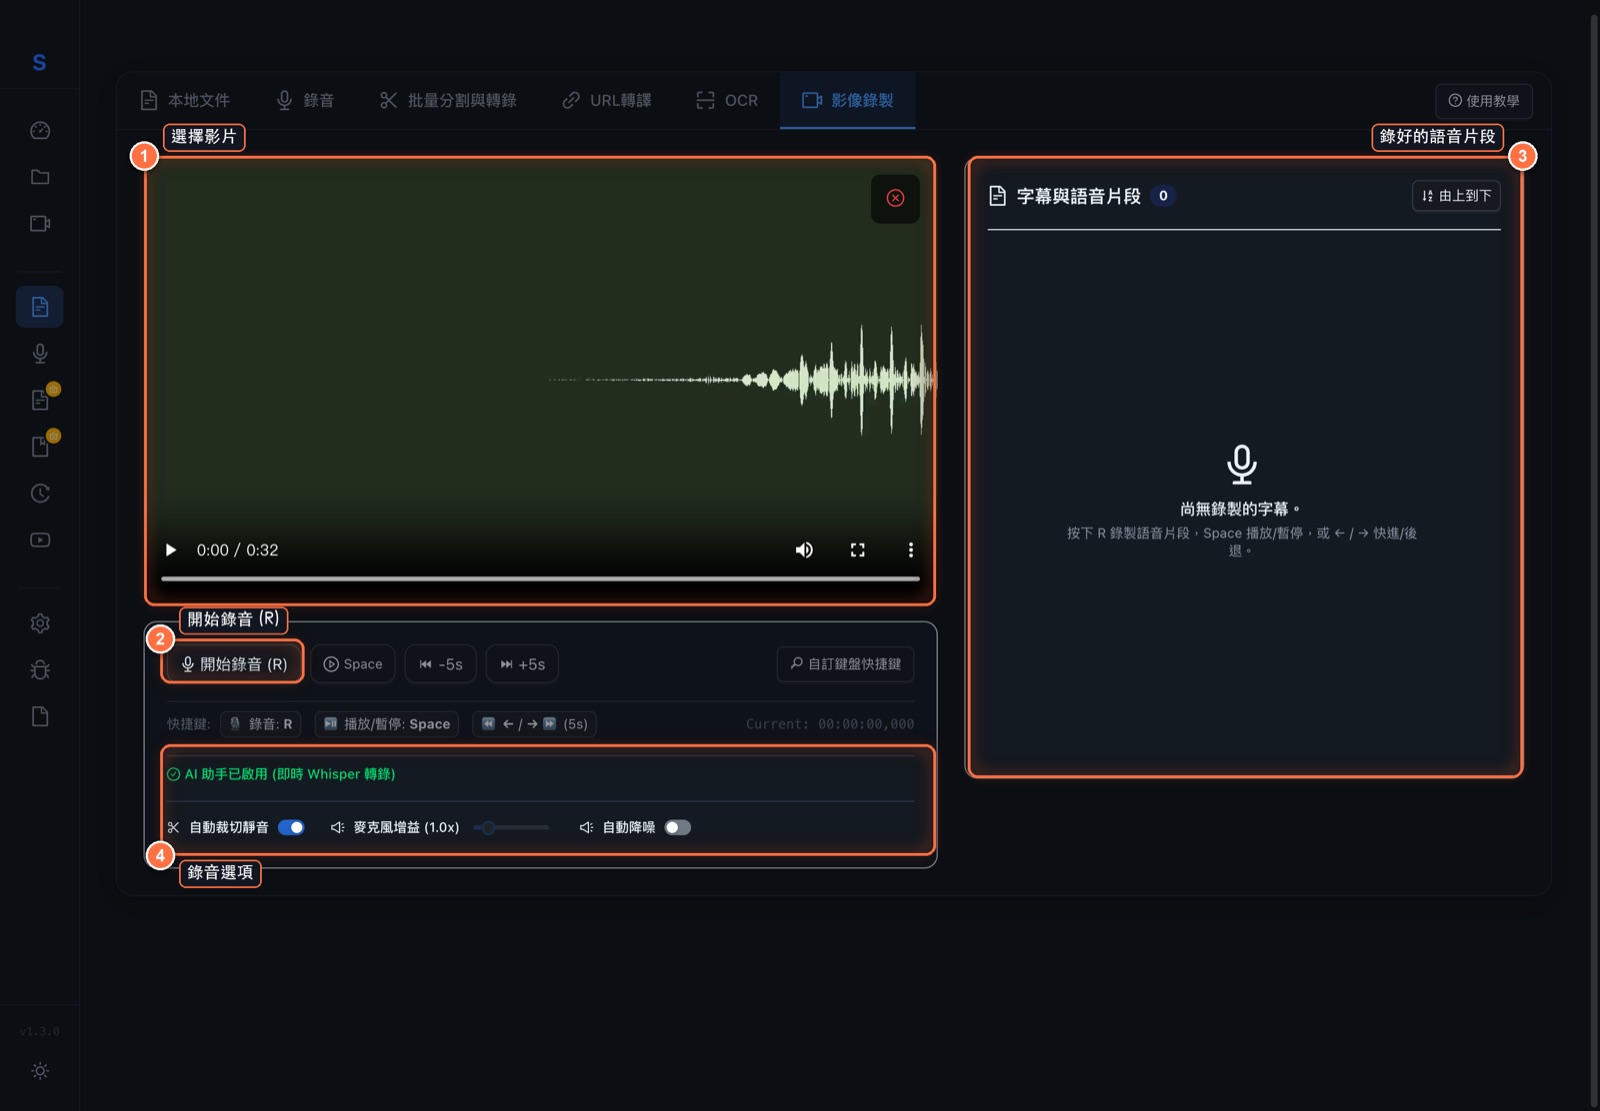
- 選一個影片檔。
- 按 「開始錄音 (R)」(或按鍵盤
R),影片會開始播放,你一邊看一邊說。 - 再按一次
R(或空白鍵)停止,右邊會多一段 語音片段。 - 重複幾次,把每一段都錄好。每一段都可以修改開始/結束時間、重聽、刪除,或修改文字。
- 完成後:
- 按 SRT 下載字幕檔;或
- 按 「合併配音與影片」:你的錄音會取代影片原本的聲音(畫面不變,錄音之間的空白會變成無聲),然後打開字幕編輯器。
- 下方顯示 「AI 助手已啟用 (即時 Whisper 轉錄)」 時,你說的話會自動變成文字;如果顯示未啟用,片段只有聲音、沒有文字,需要自己打字(到「設置 → AI 助手」開啟)。
- 自動裁切靜音(去掉片段前後沒說話的部分)、麥克風增益(聲音太小時調大)、自動降噪(去掉背景雜音,需先在「設置 → 模型 → 音訊增強」下載模型)可以讓錄音更乾淨。
- ⚠️ 錄好的片段是暫存的,關掉影片或切換分頁就會消失,請先下載 SRT 或合併。