人名與專有名詞一直辨識錯?讓校對規則從一次修正變成固定流程
人名、產品名稱和中英混用詞常被 ASR 聽錯。用詞彙清單、短樣本測試與精確字典規則,減少重複修正並避免過度替換。
人名與專有名詞一直辨識錯?讓校對規則從一次修正變成固定流程
逐字稿裡的一般句子大多看得懂,偏偏人名、品牌、型號或團隊內部縮寫一直出錯。修完一份之後,下一場錄音又要重修一次,很容易讓人以為只要換一個更大的模型就會解決。
但專有名詞的問題通常不只和模型大小有關。字詞可能很少出現在訓練資料、發音和常用詞接近,或者同一個音在不同團隊代表不同名稱。把名詞整理成可測試、可維護的校對流程,通常比盲目切換模型更有效率。
建一張精簡的名詞清單
先從最近幾份逐字稿找出反覆出錯的項目,整理四欄:
| 實際說法 | 正確寫法 | 常見辨識錯字 | 出現情境 |
|---|---|---|---|
| 產品/人名的發音 | 官方拼法 | ASR 常輸出的文字 | 例如產品規格討論 |
| 英文縮寫 | 大小寫格式 | 被拆成一般英文單字 | 例如部署會議 |
只收集重要而且常見的字詞就好。一次列入太多不熟悉的詞,會讓提示難以維護,也不容易判斷設定到底有沒有幫助。遇到同音但意思不同的名稱,要一併記下上下文,避免只留下拼音。
先用短樣本測試,再決定要不要加規則
從真實素材挑一小段,最好包含相關名詞前後的完整句子。用相同語言設定與模型做一次對照,記下錯字出現的位置,再試著提供少量名詞提示。比較兩次結果,確認正確寫法是否變多,以及其他句子有沒有被影響。
提示詞可以提供主題和詞彙線索,但不能保證模型一定採用指定拼法。若錄音本身聽不清楚,或多個名稱發音非常接近,仍應回到音訊確認。
用字典處理反覆出現的固定錯字
如果辨識結果常把同一個文字片段錯轉成固定字串,Scribis 的標準字典可以設定鍵和值,將常見錯詞改為預期寫法。建規則時用明確、少歧義的完整片語,並先在包含前後文的句子中測試。
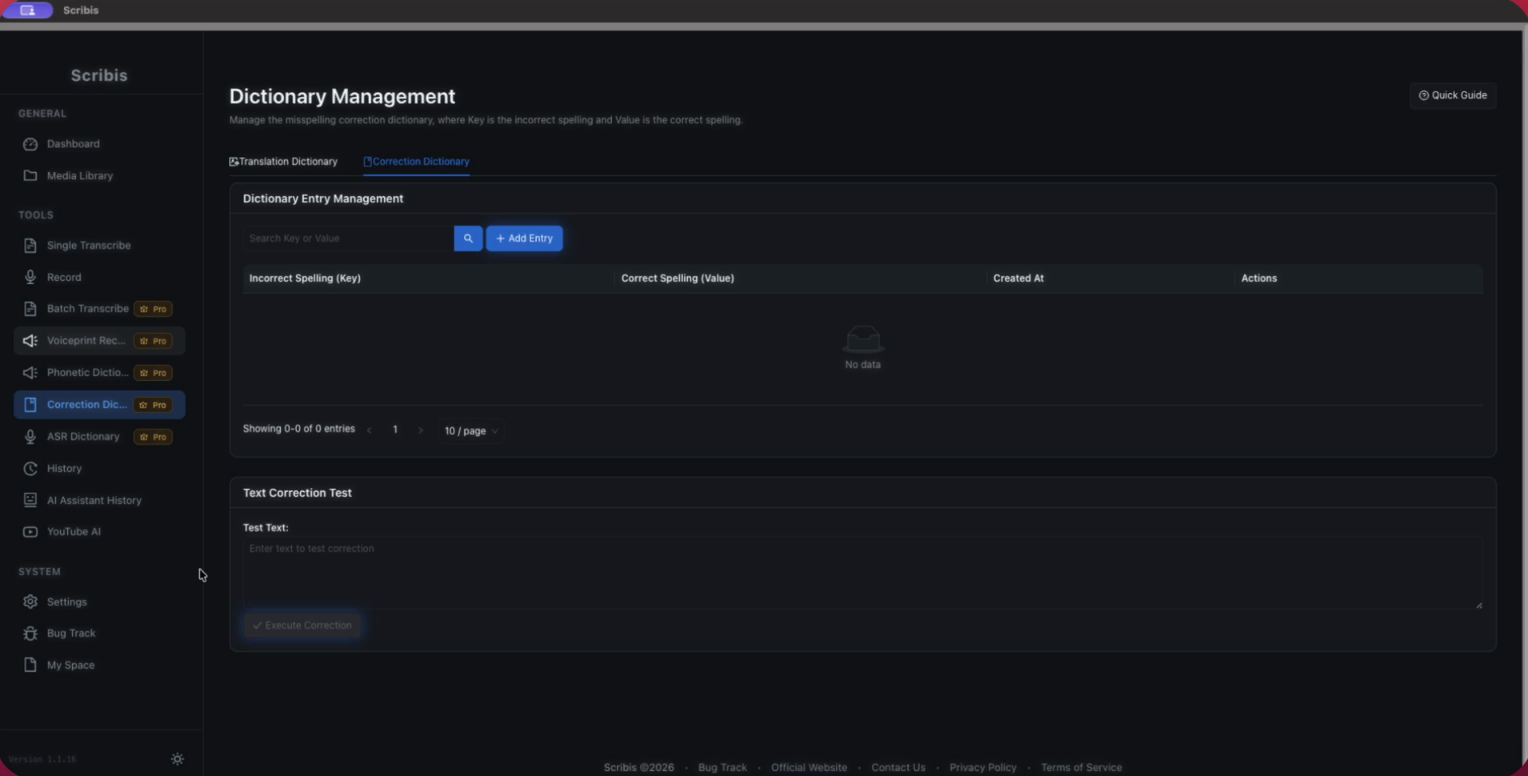
例如,一個團隊固定將產品名稱拼作「North Star」,可以把常出現的錯誤辨識結果設成鍵,再把標準拼法設成值。不要把太短、可能出現在一般句子裡的字設成通用規則,否則無關內容也可能被替換。
Scribis 的 字典與發音字典教學 有標準字典的設定畫面與測試方式。標準字典主要處理文字替換;發音字典則是發音設定,兩者用途不同。
哪些情況不能只靠替換規則?
以下狀況建議人工聽原音,不要讓固定替換規則代替判斷:
- 同一個發音可能是不同人名或產品名。
- 錯字不是固定一種,模型會依上下文輸出不同結果。
- 名稱只在極短片段出現,錄音含糊或被其他人聲蓋過。
- 日期、價格、序號等內容需要高度精確。
- 替換後的句子讀起來通順,卻可能改變原本意思。
校對時先播放名詞前後的整句,而不是只看辨識文字。聽不清楚就標記待確認,並保留原始音訊時間位置,讓下一位校對者可以快速回查。
把修正累積成團隊資產
每次完成校對後,把確定的拼法與反覆出現的錯詞補進清單,並記錄規則適用的專案或語境。定期檢查過時的產品名稱和可能撞詞的替換,再用一段代表性短音檔重測。
這樣的字典不會讓任何辨識模型變成百分之百正確,但能把已知、可重複的修正集中管理。遇到新的錯誤時,先判斷是收音、語言設定、模型,還是拼法規則造成的,再選擇相應處理方式。